没有独立显卡,我在笔记本上克隆了自己的声音(Qwen3-TTS 实测)
我想用自己的声音配音,又不想每句都录。这篇写的是在只有 CPU 的 Windows 笔记本上跑通的做法、让克隆声音变得一顿一顿的那个设置,以及我怎么挑出最好的一遍。
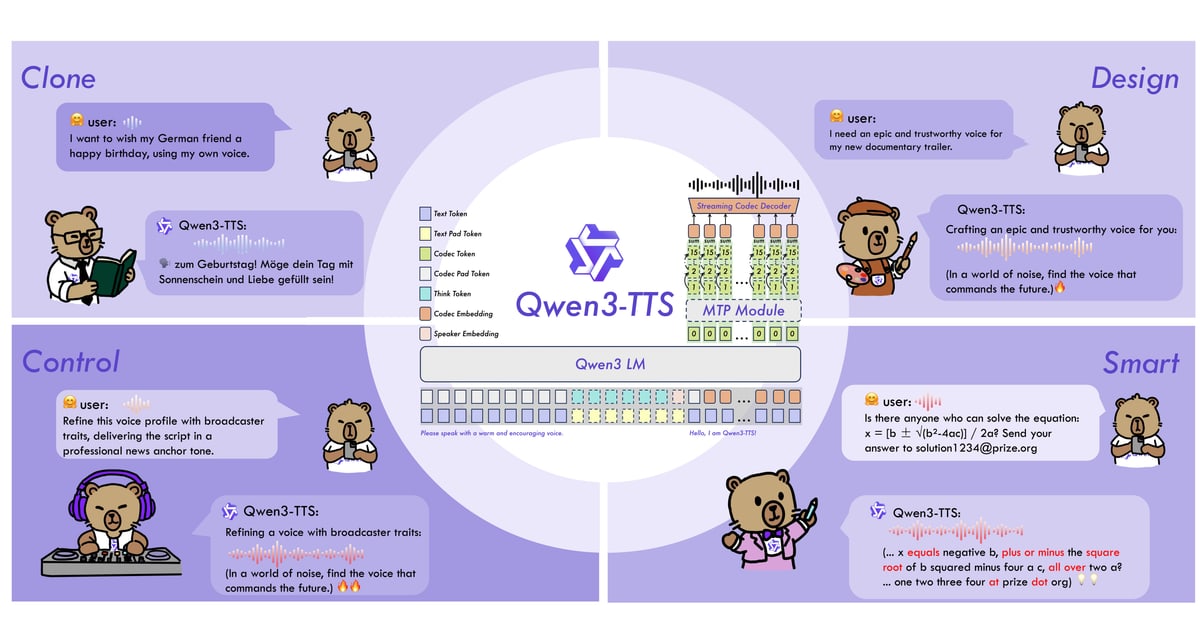
封面为 Qwen3-TTS 官方介绍图,来自通义千问团队的 GitHub 项目页。
要点
- 没有独立显卡的笔记本也能跑 Qwen3-TTS 声音克隆,每秒语音大约要算 3 到 6 秒。
- 参考音每段 7 到 15 秒,总共 30 秒左右对我来说就够了。
- 参考音是随口讲话的话,用只学音色的 x-vector 方式,否则会把你的犹豫也学去。
- 每句合成 3 到 5 遍,按停顿位置挑。
我在短视频平台发 AI 科普动画,用中文配音。每条视频最费时间的就是录旁白:说错了重录,不同天录的声音还不一样。我想写好稿子就直接得到自己声音的配音。
下面这套东西是 AI 编程助手 Claude Code 在我电脑上搭的,我负责说要什么、听效果、做决定。代码看不懂可以跳过,起作用的几个设置我都在正文里用大白话写了。
用到的东西
模型是 Qwen3-TTS-12Hz-1.7B-Base,阿里通义千问团队开源的语音合成模型(Apache-2.0 协议,代码在 github.com/Qwen/Qwen3-TTS)。能克隆声音的是 Base 版。模型文件我从 ModelScope(魔搭)下载,在国内比其他来源快得多。
它通过 qwen-tts 这个 Python 包运行,版本 0.1.1,装在 Python 3.11 的虚拟环境里。我电脑上的 Python 版本太新,机器学习的包还不支持,单独建一个 3.11 环境省了很多麻烦。
全程只用 CPU,模型用 float32 在处理器上跑,不需要 CUDA,也不需要 NVIDIA 显卡。
第一步:用现成的录像做参考音
我没有专门录音。手上有一段很长的录屏,里面是我在讲话,从里面剪了三段,加起来大约 33 秒。
片段长一点更像。7 到 15 秒的片段,克隆出来明显比 4 秒的片段更像我。
如果声音后面有背景音乐或噪音,要先把人声分离出来。在我的 CPU 上,BS-Roformer 分离模型处理 3 分钟音频要两个小时左右,太慢;audio-separator 包里的 Kim_Vocal_2 模型同样的活大约 3 分钟。
第二步:决定配音流不流畅的那个设置
Qwen3-TTS Base 有两种克隆方式:
| 方式 | 需要提供 | 学到的东西 |
|---|---|---|
| ICL(默认) | 一段音频,加上这段话的准确文字 | 你的音色,以及你在这段录音里的说话节奏 |
| 只用 x-vector | 一段或几段音频,不需要文字 | 只学音色 |
我一开始用的是默认的 ICL。问题出在参考音上:那是即兴讲话,有停顿、有犹豫,快慢不均。克隆把这些也学去了,每一句都带着同样一顿一顿的节奏,听着不流畅。
换成只用 x-vector 后就好了。音色还是我的,节奏用的是模型自己更平稳的节奏,配旁白正需要这样。因为不需要文字,还能一次给它好几段参考音。
如果你的参考音是照稿念的、很干净,ICL 也许没问题。如果是随口讲的话,先试 x-vector。
下面是我电脑上脚本的简化版:
import numpy as np, soundfile as sf, torch
from qwen_tts import Qwen3TTSModel

torch.set_num_threads(14)  # 用多少个 CPU 线程

model = Qwen3TTSModel.from_pretrained(
    "models/Qwen3-TTS-12Hz-1.7B-Base", device_map="cpu", dtype=torch.float32
)

# 把几段人声(单声道 WAV)拼起来,中间隔一小段静音
voice, sr = sf.read("my_voice.wav", dtype="float32")
gap = np.zeros(int(0.25 * sr), np.float32)
clips = [(12.0, 23.5), (61.0, 72.7), (130.2, 141.1)]  # 起止时间,单位秒
parts = []
for start, end in clips:
    parts += [voice[int(start * sr):int(end * sr)], gap]
ref = np.concatenate(parts)

# 只用 x-vector:学音色,不学节奏,不需要文字
prompt = model.create_voice_clone_prompt(
    ref_audio=(ref, sr), ref_text=None, x_vector_only_mode=True
)

wavs, out_sr = model.generate_voice_clone(
    text=["大家好,今天聊聊怎么用 AI 给视频配音。"],
    language=["Chinese"],
    voice_clone_prompt=prompt,
)
sf.write("line01.wav", wavs[0], out_sr)
如果用 ICL,就只给一段音频,把它的准确文字填进 ref_text,并把 x_vector_only_mode 设成 False。
第三步:每句多合成几遍,挑最好的
同一句话每次合成出来都不太一样。有的在该停的地方停了,有的一口气冲过了逗号。所以我每句合成 3 到 5 遍,再挑一遍用。
我听的重点是:逗号处有没有停顿,句子中间有没有不该有的长停顿。这比音色上的细微差别重要。
一条视频二十几句,每句好几遍,全听一遍很累。所以先让脚本打分排序:
- 用语音识别(中文用 Paraformer)把每一遍转成文字,和稿子对比,找出吞字、念错的。
- 拿一段没用来克隆的我本人录音做对照,算声音的相似度(CAM++ 说话人验证模型)。
- 数停顿的次数,和这句话里的逗号对比。
最后我只听排在前面的几遍。
CPU 上跑得多快?
看运行记录,每批最多 6 句:每合成 1 秒语音,大约要算 3 到 6 秒。有一批 127 秒合成了 37 秒语音,另一批 147 秒合成了 24 秒。
换算下来,2 分钟的旁白每遍要 7 到 12 分钟,合成三遍大约半小时。慢是慢,但可以放在后台跑。每次加载模型也要时间,所以我把所有句子放在一次运行里合成。
其他有用的小办法
有些字有好几个读音,模型偶尔会念错。遇到这种情况,我在送给模型的文字里换成同音字,字幕里保留正确的字。比如「长连接」写成「常连接」,「回调」写成「回掉」。
也不是每条视频都要用我的声音。做 AI 快讯这类短新闻时,我用同一系列 CustomVoice 版本自带的预设音色,不需要参考音。
只克隆你有权使用的声音
克隆你自己的声音,或者本人同意过的声音。不要发布别人声音的克隆。
付费服务会不会更省事?
大概会。ElevenLabs 这类在线服务不用自己搭环境。后来我用同一段稿子测了 ElevenLabs 免费版,它自带的普通话声音比我的克隆更自然,详见同一段中文稿子:ElevenLabs 免费版和本地开源模型对比实测。
本文用到的工具
阿里通义千问团队开源的语音合成模型,用一小段录音就能克隆声音。
换成 x-vector 方式以后,给视频配旁白够用。免费,但在 CPU 上慢,还要搭 Python 环境。
- 免费,在自己电脑上跑
- 没有独立显卡也能用
- 用 x-vector 方式时配音流畅
- 在 CPU 上每秒语音要算 3 到 6 秒
- 要装 Python、搭环境
- 多音字偶尔念错
- 和 ElevenLabs 放在一起听,没那么自然

Anthropic 出的 AI 编程助手,在你自己的电脑上干活。你用大白话说要做什么,它写代码、跑代码。
这个网站和声音克隆那篇里的脚本都是用它做的。用大白话说要做什么,检查结果,再提修改。
- 大白话就能让它写出能用的脚本
- 自己跑代码、自己改错
- 不只编程,处理文档、做视频流程也行
- 要付费
- 它做的东西还是要自己检查
- 大活儿会把额度用完,要等重置