同一段中文稿子:ElevenLabs 免费版和本地开源模型 Qwen3-TTS 对比实测
同一段 184 字的中文稿子,分别交给 ElevenLabs 免费版和没有独立显卡的笔记本上的 Qwen3-TTS,比较念错的字、停顿、速度和听起来像不像真人。
封面 Logo 来自 ElevenLabs 官方媒体素材和 Qwen3-TTS 官方项目页,商标归各自公司所有。
要点
- 凭耳朵听,ElevenLabs 自带的普通话男声 Jason Chen 最像真人;我本地克隆的声音最不自然。
- ElevenLabs 不到 8 秒就给出两版 35 秒的语音;本地模型在 CPU 上每遍要 3 分钟左右。
- 本地的预设声音每次都把英文名 Muse 按中文念;ElevenLabs 念的是英文。
- 中文在免费版里很省额度:184 个字扣 184 积分,一次给两版,每月 1 万积分大约能生成半小时中文。免费版不能商用。
声音克隆那篇文章最后留了个问题:付费服务会不会比笔记本上的免费模型更好?这次我把同一段稿子分别交给 ElevenLabs 免费版和 Qwen3-TTS,用程序分析,也用耳朵听。
怎么测的
稿子是我一条科普视频里的 5 句旁白,一共 184 个字,讲的是把 AI 助手 Muse 接入飞书。里面有逗号、冒号、用顿号隔开的一串动作,还有 4 次英文单词 Muse。配音最容易在这些地方出问题。
ElevenLabs 用的是免费版,默认模型 Eleven v4,设置全用默认(稳定性 50%,相似度 75%)。我在声音库里筛选中文、按使用人数排序,选了用的人最多的北京普通话男声 Jason Chen(8.37 万人在用),再加一个女声 Amy(3.86 万人在用)。
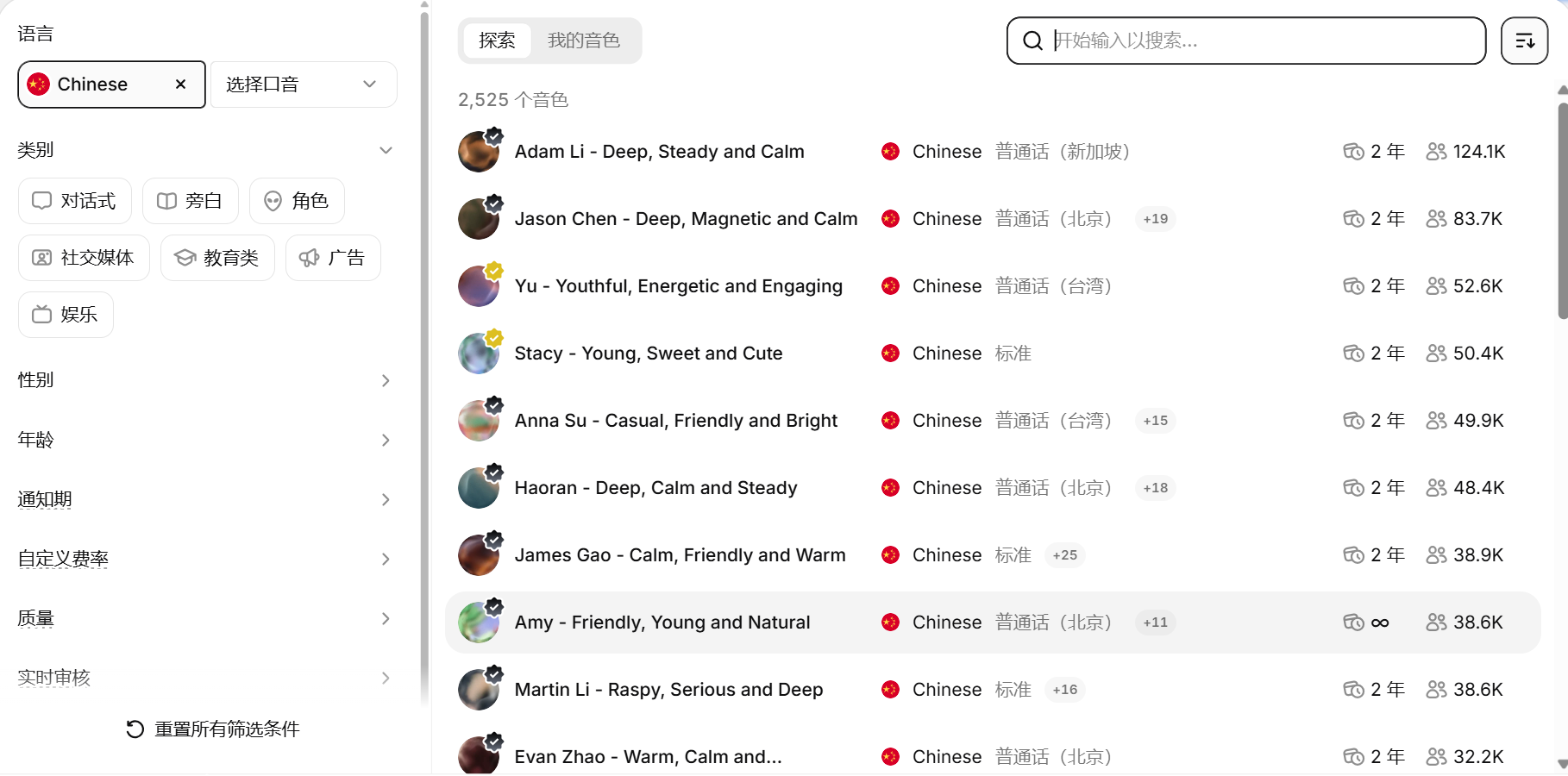
每点一次「生成」,它会把整段稿子生成两个版本。
笔记本这边用了 Qwen3-TTS 的两种声音。一种是 CustomVoice 模型自带的预设声音 dylan,要求它用标准普通话、像科技新闻主播那样念,生成两遍。另一种是上一篇里我自己的克隆声音,用的是当时挑出来最好的那一遍。
一共 7 个版本:ElevenLabs 4 个,预设声音 2 个,克隆声音 1 个。
怎么比的
先用程序逐个分析。语音识别(Paraformer)把音频转回文字,找出念错的字;再数 0.15 秒以上的明显停顿,和稿子里大约 20 个标点对比;另外量了语速和音高起伏。
然后我把 7 个版本挨个听了一遍,排了名次。
结果
| ElevenLabs Jason Chen | ElevenLabs Amy | 本地预设声音 dylan | 本地克隆的我的声音 | |
|---|---|---|---|---|
| 生成约 35 秒语音的耗时 | 两版一共不到 8 秒 | 两版一共不到 8 秒 | 每遍约 3 分钟 | 每秒语音要算 3 到 6 秒 |
| 念错的字 | 没有 | 第 2 版可能有 1 处 | Muse 每次都按中文念 | 没有 |
| 明显停顿(应有约 20 处) | 20 | 18 到 19 | 15 到 16 | 11 |
| 语速(字/秒) | 5.6 | 5.7 | 4.9 到 5.2 | 6.0 |
| 音高起伏(半音) | 4.1 | 4.3 到 4.5 | 5.9 到 7.0 | 3.0 |
| 我听下来的排名 | 最自然(第 2 版) | 中间 | 倒数第二 | 最后 |
每个版本里,语音识别都把「它」写成了「他」。两个字读音一样,不算错。
几个明显的差别
本地预设声音处理不了中文句子里的英文。语言设成中文时,它把 Muse 念成类似「缪子」「缪斯」的音,两遍一共 8 处,处处如此。ElevenLabs 和我的克隆声音念的都是英文。如果你的中文稿子里有英文产品名,先测这一点。
ElevenLabs 几乎每个标点都有停顿:Jason Chen 20 处,Amy 18 到 19 处。我的克隆声音停顿最少、语速最快,很多逗号是一口气念过去的,它也是我排在最后的那个版本。光看数字说不清它为什么听着最差,但停顿这一项它差得最明显。
音高起伏是本地预设声音最大,克隆声音最小,ElevenLabs 在中间。起伏最大和最小的两个,正好是我排在最后的两个。
Amy 第 2 版里,语音识别把「开机器人」听成了「在机器人」。可能是念错了,也可能是识别出错。
ElevenLabs 也快得多:不到 8 秒就生成了整段稿子的两个版本,而本地模型在我的 CPU 上生成同样长度的一遍要 176 到 184 秒。
免费版的额度和限制
184 个字的稿子,每生成一次扣 184 积分,给两个版本。免费版每月 1 万积分。ElevenLabs 价格页估算这些额度大约能生成 10 分钟语音,但中文每个字包含的语音更多:这次测试里 184 积分生成了大约 35 秒,算下来每月能生成半小时左右的中文。
免费版没有商用许可,所以这篇文章里没有放 ElevenLabs 的试听。它也不能克隆声音,快速克隆和商用许可都要从 Starter 版开始,每月 6 美元(我测试时首月 1 美元,优惠到 11 月 8 日)。
该选哪个
这次测试里,ElevenLabs 自带的普通话声音最自然,速度也快得多。免费版足够拿自己的稿子试一试;要用在赚钱的视频上,得开 Starter 或更高的版本。
在线 AI 配音服务,声音库很大,中文声音就有 2500 多个。
对比测试里中文配音最自然,几秒就出结果。免费版够试用,但不能商用,也不能克隆声音。
- 自带的普通话声音在测试里最自然
- 两版 35 秒语音不到 8 秒生成
- 中文省额度,免费版每月约半小时
- 免费版不能商用,也不能克隆声音
- 文字和音频都在云端处理
- 有一版可能念错了一个字
本地模型也有它的用处:想免费用自己的声音、不想让文件离开自己的电脑,或者要生成大量音频。代价是生成慢、要搭环境,中文稿子里的英文词要专门检查。
这次没测的
我只用了 ElevenLabs 的默认模型和默认设置、2525 个中文声音里的两个,以及一段很短的稿子。ElevenLabs 的声音克隆没测,因为免费版没有这个功能。
本文用到的工具
在线 AI 配音服务,声音库很大,中文声音就有 2500 多个。
对比测试里中文配音最自然,几秒就出结果。免费版够试用,但不能商用,也不能克隆声音。
- 自带的普通话声音在测试里最自然
- 两版 35 秒语音不到 8 秒生成
- 中文省额度,免费版每月约半小时
- 免费版不能商用,也不能克隆声音
- 文字和音频都在云端处理
- 有一版可能念错了一个字
阿里通义千问团队开源的语音合成模型,用一小段录音就能克隆声音。
换成 x-vector 方式以后,给视频配旁白够用。免费,但在 CPU 上慢,还要搭 Python 环境。
- 免费,在自己电脑上跑
- 没有独立显卡也能用
- 用 x-vector 方式时配音流畅
- 在 CPU 上每秒语音要算 3 到 6 秒
- 要装 Python、搭环境
- 多音字偶尔念错
- 和 ElevenLabs 放在一起听,没那么自然